
¿Qué reveló la filtración de Google de 2024?
La documentación de Content Warehouse descrita públicamente en mayo de 2024 aportó nombres de módulos, atributos y estructuras de datos relacionados con la búsqueda. No publicó el algoritmo completo, sus funciones de puntuación ni sus ponderaciones. Un campo puede estar almacenado, ser experimental u obsoleto: su existencia no demuestra su uso actual en el ranking.
Esta es una edición comentada de la traducción publicada por Agencia Cero del análisis de Mike King en iPullRank, fechado el 27 de mayo de 2024. Conservamos su recorrido técnico, ejemplos, imágenes y referencias. La primera persona, la investigación, el libro, los clientes y las ofertas comerciales del análisis pertenecen a King e iPullRank, no a Agencia Cero. Las precisiones editoriales distinguen las hipótesis de entonces de la evidencia pública y no implican acceso a sistemas internos.
Cómo leerlo: los nombres de campos se comentan como referencias históricas; las interpretaciones no son instrucciones garantizadas para posicionar. La sentencia pública de agosto de 2024, apartados sobre datos de interacción y NavBoost, aporta evidencia independiente del uso de clics en ese sistema en el período examinado. No prueba que cada atributo comentado abajo esté activo hoy ni que aumentar el CTR cause una mejora de posición.
Análisis histórico: contexto, advertencias y sistemas
Google, si estás leyendo esto, es demasiado tarde 😉 .
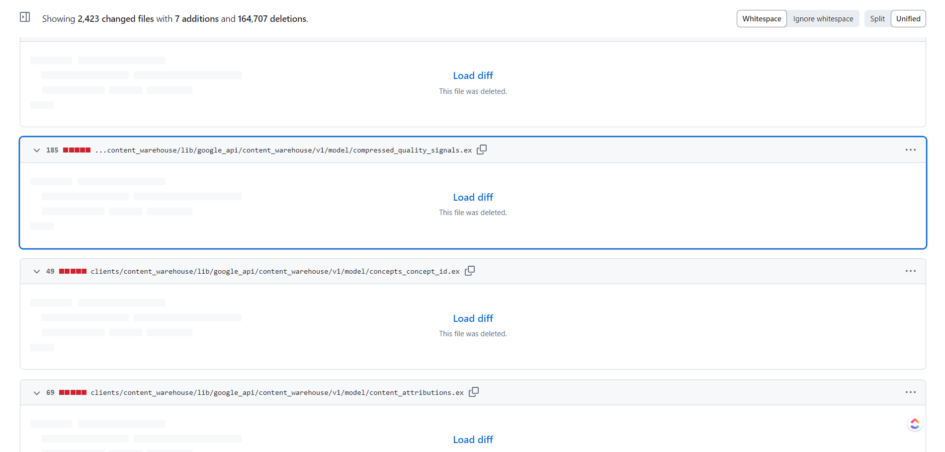
Ok. Cruje los nudillos. Vayamos al grano. Se ha filtrado documentación interna de la API Content Warehouse de Google Search. Los microservicios internos de Google parecen reflejar lo que ofrece Google Cloud Platform y la versión interna de la documentación para el obsoleto Document AI Warehouse se publicó accidentalmente de forma pública en un repositorio de código para la biblioteca de clientes. La documentación de este código también fue capturada por un servicio externo de documentación automatizada.
Según el historial citado por Mike King en mayo de 2024, la publicación accidental se corrigió el 7 de mayo de ese año. El autor mencionó una copia en un servicio de documentación y una licencia Apache 2.0 asociada al repositorio. Esta edición no verifica la disponibilidad actual de esas copias ni interpreta la licencia como autorización general para acceder a información interna, redistribuir cualquier material o recuperar código privado.
He revisado los documentos de referencia de la API y los he contextualizado con otras filtraciones anteriores de Google y con el testimonio antimonopolio del Departamento de Justicia. Estoy combinando esto con la investigación exhaustiva de patentes y libros blancos realizada para mi próximo libro, The Science of SEO (La ciencia del SEO). Aunque no hay detalles sobre las funciones de puntuación de Google en la documentación que he revisado, hay una gran cantidad de información sobre los datos almacenados para el contenido, los enlaces y las interacciones de los usuarios. También hay diversos grados de descripciones (desde decepcionantemente escasas hasta sorprendentemente reveladoras) de las características que se manipulan y almacenan.
Estaríamos tentados de llamarlos “factores de clasificación”, pero sería impreciso. La presencia de un atributo no demuestra que sea un factor de clasificación, que esté activo ni cuánto pese. Lo que voy a hacer aquí es contextualizar algunos de los sistemas y características de clasificación más interesantes (al menos, los que he podido encontrar en las primeras horas de revisión de esta filtración masiva) basándome en mi extensa investigación y en cosas que Google nos ha contado o mentido a lo largo de los años.
En el original, King critica con dureza las respuestas públicas de Google y su efecto en la credibilidad de la empresa. Aquí conservamos el debate sobre transparencia, pero no presentamos como hecho probado una intención de engañar. Una aparente contradicción requiere comparar fecha, contexto, definición y alcance de cada declaración.
Advertencias sobre el artículo
Creo que todos sabemos que la gente se esforzará por desacreditar mis conclusiones y análisis de esta filtración. Algunos se preguntarán por qué importa y dirán “pero eso ya lo sabíamos”. Así que quitemos las advertencias de en medio antes de pasar a lo bueno.
- Tiempo y contexto limitados: Con el fin de semana festivo, sólo he podido dedicar unas 12 horas a concentrarme a fondo en todo esto. Estoy increíblemente agradecido a algunas partes anónimas que fueron de gran ayuda al compartir sus conocimientos conmigo para ayudarme a ponerme al día rápidamente. Además, al igual que con la filtración de Yandex que cubrí el año pasado, no tengo una imagen completa. Mientras que en el caso de Yandex teníamos el código fuente para analizar y ninguna de las ideas que había detrás, en este caso tenemos algunas de las ideas que hay detrás de miles de funciones y módulos, pero no el código fuente. Tendrás que perdonarme por compartir esto de una manera menos estructurada de lo que lo haré en unas semanas después de haberme sentado con el material por más tiempo.
- No hay funciones de puntuación: No sabemos cómo se ponderan las características en las distintas funciones de puntuación posteriores. No sabemos si se utiliza todo lo disponible. Sabemos que algunas características están obsoletas. A menos que se indique explícitamente, no sabemos cómo se utilizan las cosas. No sabemos dónde ocurre cada cosa en el proceso. Tenemos una serie de sistemas de clasificación con nombre que se ajustan vagamente a cómo Google los ha explicado, cómo los SEO han observado las clasificaciones en la naturaleza, y cómo las solicitudes de patentes y la literatura IR explica. En última instancia, gracias a esta filtración, ahora tenemos una imagen más clara de lo que se está considerando que puede informar a lo que nos centramos en contra de ignorar en SEO de cara al futuro.
- Probablemente el primero de varios posts : Este post será mi puñalada inicial de lo que he revisado. Es posible que publique entradas posteriores a medida que continúe profundizando en los detalles. Sospecho que este artículo dará lugar a que la comunidad SEO se apresure a analizar estos documentos y, colectivamente, estaremos descubriendo y recontextualizando cosas durante los próximos meses.
- Contexto temporal: King interpretó el material como una instantánea de marzo de 2024 y citó una publicación el 27 de marzo y una retirada el 7 de mayo de 2024. Esas fechas no demuestran que cada campo estuviera activo entonces ni que describa el sistema vigente hoy.
- Correlación no es causalidad: Una asociación observada entre un cambio y el tráfico no prueba su causa. Tampoco la existencia de un campo demuestra que determine una posición.
Más de 14.000 atributos documentados: no equivalen a factores de ranking
Hay 2.596 módulos representados en la documentación de la API con 14.014 atributos (características) que tienen este aspecto:
Los módulos están relacionados con componentes de YouTube, Assistant, Books, búsqueda de vídeos, enlaces, documentos web, infraestructura de rastreo, un sistema de calendario interno y la API People. Al igual que Yandex, los sistemas de Google funcionan en un repositorio monolítico (o “monorepo”) y las máquinas operan en un entorno compartido. Esto significa que todo el código se almacena en un único lugar y que cualquier máquina de la red puede formar parte de cualquiera de los sistemas de Google.
La documentación filtrada describe cada módulo de la API y los desglosa en resúmenes, tipos, funciones y atributos. La mayor parte de lo que estamos viendo son las definiciones de propiedades para varios búferes de protocolo (o protobufs) a los que se accede a través de los sistemas de clasificación para generar SERPs (Search Engine Result Pages: lo que Google muestra a los buscadores después de realizar una consulta).
Por desgracia, muchos de los resúmenes hacen referencia a enlaces Go, que son URL de la intranet corporativa de Google, que ofrecen detalles adicionales sobre distintos aspectos del sistema. Sin las credenciales de Google adecuadas para acceder y ver estas páginas (lo que casi con toda seguridad requeriría ser un Googler actual del equipo de Búsqueda), nos vemos abandonados a nuestra suerte para interpretarlas.
Documentación y declaraciones públicas: qué diferencias se pueden interpretar
El análisis original cuestiona si las explicaciones públicas de Google describían adecuadamente sus sistemas. Es una crítica del autor, no una prueba de intención de engaño. Al contrastar declaraciones y documentación, conviene distinguir métricas comerciales de terceros, nombres internos, sistemas históricos y funcionamiento actual.
A continuación, presento declaraciones históricas de empleados de Google junto con interpretaciones de la documentación con comentarios limitados para que puedas juzgar por ti mismo.
“No tenemos nada parecido a la autoridad de dominio”
Los portavoces de Google han dicho en numerosas ocasiones que no utilizan la “autoridad de dominio”. King interpretó estas respuestas como incompletas; esa valoración no demuestra por sí sola una falsedad deliberada.
Al decir que no utilizan la autoridad de dominio, podrían estar diciendo específicamente que no utilizan la métrica de Moz llamada “Domain Authority” (obviamente ). También podrían estar diciendo que no miden la autoridad o importancia de un tema específico (o dominio) en relación con un sitio web. Esta confusión semántica les permite no responder nunca directamente a la pregunta de si calculan o utilizan métricas de autoridad para todo el sitio.
Gary Ilyes, analista del equipo de búsqueda de Google que se dedica a publicar información para ayudar a los creadores de sitios web, ha repetido esta afirmación en numerosas ocasiones.
Y Gary no está solo. John Mueller, un “defensor de las búsquedas que coordina las relaciones de búsqueda de Google” declaró en este vídeo “no tenemos puntuación de autoridad del sitio web”.
En realidad, como parte de las Señales de Calidad Comprimidas que se almacenan por documento, Google tiene una característica que computan llamada “siteAuthority”.
No sabemos específicamente cómo se calcula siteAuthority ni cómo se utiliza en funciones de puntuación. El nombre del campo no permite equipararlo con Domain Authority de Moz, probar su uso actual en Q* o deducir una ponderación. Es una pista para estudiar posibles señales de sitio, no una métrica que el propietario pueda optimizar directamente.
“No utilizamos los clics para la clasificación”
Acabemos con esto de una vez por todas.
El testimonio de Pandu Nayak en el juicio antimonopolio del DOJ reveló recientemente la existencia de los sistemas de clasificación Glue y NavBoost. NavBoost es un sistema que emplea medidas basadas en los clics para mejorar, degradar o reforzar una clasificación en la búsqueda web. Nayak indicó que Navboost existe desde 2005 e históricamente utilizaba 18 meses consecutivos de datos de clics. El sistema se actualizó recientemente para utilizar 13 meses de datos y se centra en los resultados de búsqueda web, mientras que un sistema llamado Glue se asocia con otros resultados de búsqueda universales. Pero, incluso antes de esa revelación, disponíamos de varias patentes (incluida la de 2007 sobre Time Based Ranking) que indican específicamente cómo pueden utilizarse los registros de clics para cambiar los resultados.
Los clics pueden aportar información sobre el éxito de una búsqueda, pero admiten sesgos y requieren interpretación. El aprendizaje automático y las patentes ayudan a plantear hipótesis; por sí solos no confirman qué función está en producción. La discusión pública sobre NavBoost debe apoyarse en testimonios y documentos judiciales, además de comentarios de especialistas.
Gary Ilyes ha abordado esta cuestión de la medición de clics muchas veces. En una ocasión reforzó lo que el ingeniero de Google Search Paul Haahr compartió en su charla de SMX West de 2016 sobre experimentos en vivo, diciendo que “utilizar los clics directamente en los rankings sería un error”.
Más tarde, utilizó su plataforma para menospreciar a Rand Fishkin (fundador y CEO de Moz, y un veterano en SEO) diciendo que “el tiempo de permanencia, el CTR, cualquiera que sea la nueva teoría de Fishkin, son generalmente basura inventada”.
En realidad, Navboost dispone de un módulo específico dedicado por completo a las señales de clic.
El resumen de ese módulo lo define como “señales de clics e impresiones para Craps”, uno de los sistemas de clasificación. Como vemos a continuación, se consideran como métricas los clics malos, los clics buenos, los últimos clics más largos, los clics no aplastados y los últimos clics más largos no aplastados. Según la patente de Google “Scoring local search results based on location prominence”, “Squashing is a function that prevents one large signal from dominating the others”. En otras palabras, los sistemas normalizan los datos de clics para garantizar que no haya una manipulación descontrolada basada en la señal de clics. Los responsables de Google argumentan que los sistemas que aparecen en patentes y libros blancos no son necesariamente los que están en producción, y esa cautela sigue siendo válida: el uso de NavBoost tiene evidencia pública independiente, pero eso no valida cada interpretación de los atributos ni revela sus pesos actuales.
Muchas de estas mismas medidas basadas en los clics se encuentran también en otro módulo relacionado con las señales de indexación. Una de las medidas es la fecha del “último buen clic” en un documento determinado. Esto motivó una hipótesis sobre la relación entre interacción y pérdida de tráfico. No permite diagnosticar una caída ni demostrar que exista una cuota esperada de clics para cada posición.
Además, la documentación representa a los usuarios como votantes y sus clics se almacenan como sus votos. El sistema cuenta el número de clics erróneos y segmenta los datos por país y dispositivo.
El análisis describe referencias al clic más largo de una sesión. No permiten equiparar automáticamente clic largo, tiempo de permanencia y tiempo en página medido por Analytics. Tampoco establecen un mínimo de segundos ni justifican alargar artificialmente la navegación. La prioridad práctica es que la persona complete su tarea con facilidad.
Varias fuentes han indicado que NavBoost es “ya una de las señales de clasificación más potentes de Google”. La documentación filtrada especifica “Navboost” por su nombre 84 veces, con cinco módulos que incluyen Navboost en el título. También hay pruebas de que contemplan su puntuación a nivel de subdominio, dominio raíz y URL, lo que indica intrínsecamente que tratan de forma diferente los distintos niveles de un sitio. No voy a entrar en la discusión subdominio vs. sudominio, pero más adelante hablaremos de cómo los datos del sistema también han informado al algoritmo Panda.
Así que, sí, Google no menciona “CTR” o “tiempo de permanencia” con esas palabras exactas en esta documentación, pero se incluye el espíritu de lo que Rand demostró: clics en los resultados de búsqueda y medidas de una sesión de búsqueda satisfactoria. La evidencia judicial pública respalda el uso histórico de interacciones en NavBoost. No demuestra que subir el CTR de una página o su tiempo en Analytics cause una mejora de posición, ni autoriza a generalizar cada hipótesis del artículo.
“No hay Sandbox”
Los portavoces de Google han sido categóricos al afirmar que no existe un sandbox al que se segreguen los sitios web en función de su antigüedad o de la falta de señales de confianza. En un tuit ahora eliminado, John Muller respondió a una pregunta sobre cuánto tiempo se tarda en ser elegible para clasificar indicando que “No hay sandbox”.
En el módulo PerDocData, la documentación indica un atributo llamado hostAge que se utiliza específicamente “para sandbox spam fresco en tiempo de servicio”.
La referencia a hostAge y al spam nuevo no demuestra un sandbox universal para todos los sitios recientes. El nombre y la descripción de un atributo no bastan para deducir un período fijo de espera ni una penalización por antigüedad.
“No utilizamos nada de Chrome para el Ranking”
Anteriormente se había citado a Matt Cutts diciendo que Google no utiliza los datos de Chrome como parte de la búsqueda orgánica. Más recientemente, John Mueller reforzó esta idea.
Uno de los módulos relacionados con las puntuaciones de calidad de las páginas presenta una medida a nivel de sitio de las visitas desde Chrome. Otro módulo que parece estar relacionado con la generación de sitelinks también tiene un atributo relacionado con Chrome.
Una presentación interna filtrada de mayo de 2016 sobre el sistema RealTime Boost también indica que los datos de Chrome iban a llegar a las búsquedas. Es una referencia histórica que no demuestra por sí sola cómo se usaban esos datos ni cómo se usan hoy.
Los portavoces de Google tienen buenas intenciones, pero ¿podemos fiarnos de ellos?
La respuesta exige contrastar fuentes. Las declaraciones públicas, los testimonios y los análisis técnicos tienen alcances distintos; un atributo relacionado con Chrome no demuestra que cualquier visita desde ese navegador mejore el ranking.
No albergo mala voluntad contra las personas que he citado aquí. Estoy seguro de que todos ellos hacen todo lo posible por ofrecer apoyo y valor a la comunidad dentro de los límites permitidos. Sin embargo, estos documentos dejan claro que debemos seguir tomando lo que dicen como una aportación y nuestra comunidad debe seguir experimentando para ver qué funciona.
Una interpretación de la arquitectura de búsqueda de Google
Nota editorial: el inventario que sigue es un mapa interpretativo de 2024. Conserva nombres y funciones atribuidas por King, no una especificación técnica vigente ni verificada de extremo a extremo. Las analogías con WordPress y los ejemplos de restricciones de resultados ayudan a explicar posibilidades; no son reglas públicas de composición de cada SERP.
Conceptualmente, puedes pensar en “el algoritmo de Google” como una sola cosa, una ecuación gigante con una serie de factores de clasificación ponderados. En realidad, se trata de una serie de microservicios en los que muchas funciones se procesan previamente y se ponen a disposición en tiempo de ejecución para componer la SERP. Según los distintos sistemas a los que se hace referencia en la documentación, puede haber más de cien sistemas de clasificación diferentes. Suponiendo que estos no sean todos los sistemas, quizás cada uno de los sistemas por separado represente una “señal de clasificación” y quizás así es como Google llega a las 200 señales de clasificación de las que habla a menudo.
En la charla de Jeff Dean “Building Software Systems at Google and Lessons Learned”, mencionó que las primeras iteraciones de Google enviaban cada consulta a 1.000 máquinas para que la procesaran y respondieran en menos de 250 milisegundos. También hizo un diagrama de una versión anterior de la abstracción de la arquitectura del sistema. Este diagrama ilustra que Super Root es el cerebro de la Búsqueda de Google que envía las consultas y lo une todo al final.
El distinguido ingeniero de investigación Marc Najork, en su reciente presentación sobre la recuperación de información generativa, mostró un modelo abstracto de la búsqueda de Google con su sistema RAG (también conocido como Search Generative Experience/AI Overviews). Este diagrama ilustra una serie de diferentes almacenes de datos y servidores que procesan las distintas capas de un resultado.
El informante de Google, Zach Vorhies, filtró esta diapositiva que muestra las relaciones de diferentes sistemas dentro de Google por sus nombres internos. En la documentación se hace referencia a varios de ellos.
Utilizando estos tres modelos de alto nivel, podemos empezar a pensar en cómo algunos de estos componentes juegan juntos. Por lo que puedo deducir de la documentación, parece que esta API se basa en Spanner de Google. Spanner es una arquitectura distribuida que permite ampliar el almacenamiento de datos y la capacidad de procesamiento, al tiempo que trata una serie de ordenadores conectados en red globalmente como uno solo.
Hay que admitir que es algo difícil entender la relación entre todo a partir de la documentación, pero el currículum de Paul Haahr ofrece una valiosa perspectiva de lo que hacen algunos de los sistemas de clasificación mencionados. Destacaré los que conozco por su nombre y los segmentaré según su función.
Rastreo
- Trawler: El sistema de rastreo web. Dispone de una cola de rastreo, mantiene las tasas de rastreo y comprende la frecuencia con la que cambian las páginas.
Indexación
- Alexandria: El núcleo del sistema de indexación.
- SegIndexer : Sistema que coloca los documentos en niveles dentro del índice.
- TeraGoogle: Sistema de indexación secundario para documentos que viven en el disco a largo plazo.
Renderización
- HtmlrenderWebkitHeadless: Sistema de renderizado para páginas JavaScript. Curiosamente, su nombre se debe a Webkit y no a Chromium. En la documentación se menciona Chromium, por lo que es probable que Google utilizara WebKit en un principio y cambiara a Headless Chrome en cuanto llegó.
Procesamiento
- LinkExtractor: Extrae enlaces de las páginas.
- WebMirror: Sistema para gestionar la canonicalización y la duplicación.
Clasificación
- Mustang: El sistema primario de puntuación, clasificación y servicio.
- Ascorer : El algoritmo primario de clasificación que clasifica las páginas antes de cualquier ajuste de re-clasificación.
- NavBoost: Sistema de re-ranking basado en los registros de clics del comportamiento de los usuarios.
- FreshnessTwiddler: Sistema de reordenación de documentos basado en la frescura.
- WebChooserScorer : Define los nombres de las características utilizadas en la puntuación de fragmentos.
Servidor
- Google Web Server: GWS es el servidor con el que interactúa el frontend de Google. Recibe las cargas útiles de datos para mostrarlas al usuario.
- SuperRoot: es el cerebro de la Búsqueda de Google que envía mensajes a los servidores de Google y gestiona el sistema de postprocesamiento para la reclasificación y la presentación de resultados.
- SnippetBrain: El sistema que genera snippets para los resultados.
- Glue: El sistema para reunir resultados universales utilizando el comportamiento del usuario.
- Cookbook: Sistema de generación de señales. Hay indicios de que los valores se crean en tiempo de ejecución.
Como ya he dicho, hay muchos más sistemas descritos en estos documentos, pero no está del todo claro lo que hacen. Por ejemplo, SAFT y Drishti del diagrama anterior también están representados en estos documentos, pero sus funciones no están claras.
¿Qué son los Twiddlers o ajustes de reclasificación?
Hay poca información en línea sobre los Twiddlers en general, así que creo que merece la pena explicarlos aquí para que podamos contextualizar mejor los distintos sistemas Boost que encontramos en los documentos.
Los Twiddlers son funciones de re-clasificación que se ejecutan después del algoritmo primario de búsqueda Ascorer. Funcionan de forma similar a como lo hacen los filtros y las acciones en WordPress, donde lo que se muestra se ajusta justo antes de ser presentado al usuario. Los Twiddlers pueden ajustar la puntuación de recuperación de información de un documento o cambiar la clasificación de un documento. Muchos de los experimentos en vivo y los sistemas con nombre que conocemos se implementan de esta manera. Como demuestra este Xoogler, son bastante importantes en diversos sistemas de Google:
Los Twiddlers pueden ofrecer restricciones de categoría, lo que significa que se puede promover la diversidad limitando específicamente el tipo de resultados. Por ejemplo, el autor puede decidir permitir sólo 3 entradas de blog en una SERP determinada. Esto puede aclarar cuándo la clasificación es una causa perdida basada en el formato de su página.
Cuando Google dice que algo como Panda no formaba parte del algoritmo principal, probablemente significa que se lanzó como un Twiddler como un cálculo de mejora o degradación del reranking y más tarde se trasladó a la función de puntuación principal. Piense que es similar a la diferencia entre la renderización del lado del servidor y del lado del cliente.
Presumiblemente, cualquiera de las funciones con el sufijo Boost opera utilizando el marco Twiddler. Éstos son algunos de los Boosts identificados en la documentación:
- NavBoost
- QualityBoost
- RealTimeBoost
- WebImageBoost
Los nombres orientan hipótesis, pero no explican por sí solos la función, la implementación o el uso actual de cada sistema.
También hay un documento interno sobre Twiddlers que he revisado que habla de esto con más detalle, pero este post suena como si el autor hubiera visto el mismo documento que yo.
Hallazgos e hipótesis para revisar una estrategia SEO
Vayamos a lo que realmente has venido a buscar. ¿Qué está haciendo Google que no sabíamos o de lo que no estábamos seguros y cómo puede afectar a mis esfuerzos de SEO?
Nota rápida antes de continuar. Siempre es mi objetivo exponer la industria SEO a nuevos conceptos. No es mi objetivo para darle una receta sobre cómo utilizarlo para su caso de uso específico. Si eso es lo que quiere, debe contratar iPullRank para su SEO. De lo contrario, siempre hay más que suficiente para que usted pueda extrapolar y desarrollar sus propios casos de uso.
Hipótesis sobre Panda a partir de patentes
Nota editorial: una patente describe una invención, no certifica su despliegue. La fórmula y las citas siguientes se conservan como ejemplos del razonamiento del autor. Según la guía pública de sistemas de Google, Panda se integró en los sistemas principales en 2015; el sistema de contenido útil pasó a formar parte de los sistemas principales en marzo de 2024.
Cuando se lanzó Panda hubo mucha confusión. ¿Es aprendizaje automático? ¿Utiliza señales de usuario? ¿Por qué necesitamos una actualización para recuperarnos? ¿Es en todo el sitio? ¿Por qué he perdido tráfico en un determinado subdirectorio?
Panda se lanzó bajo la dirección de Amit Singhal. Singhal estaba decididamente en contra del aprendizaje automático debido a su limitada observabilidad. De hecho, hay una serie de patentes centradas en la calidad de los sitios para Panda, pero en la que quiero centrarme es en la no descriptiva “Clasificación de los resultados de búsqueda”. La patente aclara que Panda es mucho más simple de lo que pensábamos. Se trata en gran medida de construir un modificador de puntuación basado en señales distribuidas relacionadas con el comportamiento de los usuarios y los enlaces externos. Ese modificador puede aplicarse a nivel de dominio, subdominio o subdirectorio.
“El sistema genera un factor de modificación para el grupo de recursos a partir del recuento de enlaces independientes y del recuento de consultas de referencia (paso 306). Por ejemplo, el factor de modificación puede ser una relación entre el número de enlaces independientes para el grupo y el número de consultas de referencia para el grupo. Es decir, el factor de modificación (M) puede expresarse como:
M=IL/RQ,
donde IL es el número de enlaces independientes contados para el grupo de recursos y RQ es el número de consultas de referencia contadas para el grupo de recursos”.
Los enlaces independientes son básicamente lo que consideramos dominios raíz de enlace, pero las consultas de referencia son un poco más complicadas. Así es como se definen en la patente:
“Una consulta de referencia para un grupo particular de recursos puede ser una consulta de búsqueda previamente enviada que ha sido categorizada como referida a un recurso en el grupo particular de recursos. La categorización de una consulta de búsqueda particular previamente enviada como referida a un recurso en el grupo particular de recursos puede incluir: determinar que la consulta de búsqueda particular previamente enviada incluye uno o más términos que han sido determinados para referirse al recurso en el grupo particular de recursos.”
King relacionó las consultas de referencia de la patente con NavBoost. Es una interpretación del autor; ni una patente ni el nombre de un campo prueban que esa equivalencia describa la implementación de Panda.
Esto sugiere que las actualizaciones de Panda eran simplemente actualizaciones de la ventana móvil de consultas, de forma similar a como funcionan los cálculos de Core Web Vitals. También podría significar que las actualizaciones del gráfico de enlaces no se procesaban en tiempo real para Panda.
No es por polemizar, pero otra patente de Panda, la puntuación de calidad del sitio, también contempla una puntuación que es una relación entre las consultas de referencia y las selecciones o clics del usuario.
La recomendación práctica es atraer público pertinente, desarrollar contenido útil y facilitar una buena experiencia. La fórmula de la patente se conserva como ejemplo de un mecanismo propuesto, no como fórmula operativa de Panda. No hay base aquí para prometer recuperación de una actualización mediante más clics, más enlaces o una proporción concreta entre ambos.
Los autores son una característica explícita
Se ha escrito mucho sobre E-E-A-T. Muchos SEO son incrédulos debido a lo nebuloso que es puntuar la experiencia y la autoridad. También he destacado anteriormente lo poco que el marcado de autor está realmente en la web. Antes de conocer las incrustaciones vectoriales, no creía que la autoría fuera una señal suficientemente viable a escala web.
No obstante, Google almacena explícitamente los autores asociados a un documento como texto:
También buscan determinar si una entidad de la página es también el autor de la misma.
Esto, combinado con el mapeo exhaustivo de entidades e incrustaciones que se muestra en estos documentos, sugiere que los sistemas pueden representar autores y entidades. No demuestra una puntuación universal de autoría ni una bonificación automática por añadir una firma.
Posibles degradaciones algorítmicas
Nota editorial: estas etiquetas y sus posibles funciones pertenecen al análisis original. En particular, Nav Demotion, las degradaciones de ubicación y la asociación con reviews son interpretaciones, no diagnósticos que se puedan aplicar a una web por el nombre de un campo.
Hay una serie de degradaciones algorítmicas comentadas en la documentación. Las descripciones son limitadas, pero vale la pena mencionarlas. Ya hemos hablado de Panda, pero el resto de degradaciones que he encontrado son:
- Anchor Mismatch: Cuando el enlace no coincide con el sitio de destino al que enlaza, el enlace es degradado en los cálculos. Como he dicho antes, Google busca relevancia en ambos lados de un enlace.
- Descenso de la SERP: señal que indica un descenso basado en factores observados en la SERP, lo que sugiere una posible insatisfacción del usuario con la página, medida probablemente por los clics.
- Nav Demotion: Presumiblemente, se trata de una degradación aplicada a páginas que muestran malas prácticas de navegación o problemas de experiencia de usuario.
- Descenso de dominios de coincidencia exacta: A finales de 2012, Matt Cutts anunció que los dominios de coincidencia exacta no recibirían tanto valor como lo hacían históricamente. Existe una función específica para su degradación.
- Product Review Demotion: No hay información específica sobre esto, pero está listado como una degradación y probablemente relacionado con la reciente actualización de 2023 de las revisiones de productos.
- Degradación de ubicación: se indica que las páginas “globales” y “superglobales” pueden degradarse. Esto sugiere que Google intenta asociar páginas con una ubicación y clasificarlas en consecuencia.
- Descensos de porno: Este es bastante obvio.
- Otras degradaciones de enlaces: lo veremos en la siguiente sección.
Todas estas degradaciones potenciales pueden informar una estrategia, pero se reduce a hacer un contenido estelar con una fuerte experiencia de usuario y la construcción de una marca, si somos honestos.
Los enlaces siguen siendo importantes
No he visto ninguna prueba que refute las recientes afirmaciones de que los enlaces se consideran menos importantes. Una vez más, es probable que esto se deba a las propias funciones de puntuación y no a la forma en que se almacena la información. Dicho esto, se ha puesto mucho cuidado en extraer y diseñar características para comprender en profundidad el gráfico de enlaces.
Hipótesis sobre el nivel de indexación y el valor de los enlaces
Una métrica denominada sourceType que muestra una relación poco clara entre el lugar en el que se indexa una página y su valor. Para que te hagas una idea, el índice de Google está estratificado en niveles en los que el contenido más importante, que se actualiza con regularidad y al que se accede, se almacena en memoria flash. El contenido menos importante se almacena en unidades de estado sólido y el contenido que se actualiza de forma irregular se almacena en discos duros estándar.
King interpretó estos niveles como una posible relación entre almacenamiento y valoración de enlaces. El atributo sourceType no basta para probar esa relación ni la regla de que una página fresca aporta un enlace más valioso. La vigencia, relevancia y utilidad de una referencia se deben evaluar por su contexto, no por una supuesta ubicación física en el índice.
Señales de velocidad de spam de enlaces
Hay toda una serie de métricas sobre la identificación de picos de spam anchor text. Tomando nota de la función phraseAnchorSpamDays, Google tiene efectivamente la capacidad de medir la velocidad de enlace de spam.
Esto podría utilizarse fácilmente para identificar cuándo un sitio está haciendo spam y para anular un ataque de SEO negativo. Para aquellos que son escépticos acerca de esto último, Google puede utilizar estos datos para comparar una línea de base de descubrimiento de enlaces contra una tendencia actual y simplemente no contar esos enlaces en cualquier dirección.
La referencia a 20 versiones no demuestra un límite general de Google
Ya he hablado anteriormente de cómo el sistema de archivos de Google es capaz de almacenar versiones de páginas a lo largo del tiempo de forma similar a Wayback Machine. El análisis plantea que Google puede conservar versiones históricas, pero no demuestra que guarde indefinidamente todo lo que ha indexado. Esta es una de las razones por las que no se puede simplemente redirigir una página a un objetivo irrelevante y esperar que el link equity fluya.
Los docs refuerzan esta idea dando a entender que guardan todos los cambios que han visto para la página.
Cuando sacan datos a la superficie para compararlos recuperando DocInfo, sólo tienen en cuenta las 20 últimas versiones de la página.
La referencia a 20 versiones corresponde a la interpretación de ese componente. No demuestra que 20 cambios o solicitudes de indexación borren el historial de una URL. Corregir contenido y redirecciones debe responder a su pertinencia y utilidad, no a una supuesta fórmula de «borrón y cuenta nueva».
PageRank de la página de inicio: posibles relaciones entre documentos
Cada documento tiene asociado su PageRank de página de inicio (la versión Nearest Seed). Es probable que se utilice como proxy para las páginas nuevas hasta que obtengan su propio PageRank.
Es probable que esto y siteAuthority se utilicen como proxies para nuevas páginas hasta que tengan su propio PageRank calculado.
Página principal de Confianza
La documentación llevó a King a plantear que la confianza asociada a la página de inicio podría intervenir en la valoración de enlaces. Aquí no se demuestra su uso, peso ni aplicación actual.
Como siempre, deberías centrarte en la calidad y relevancia de tus enlaces en lugar de en el volumen.
Tamaño de letra: una característica documentada, no una táctica demostrada
Nota editorial: registrar características de presentación no prueba que agrandar textos o enlaces mejore posiciones. Usa jerarquía visual por legibilidad y accesibilidad. Del mismo modo, droppedLocalAnchorCount no demuestra por sí solo que Penguin elimine los enlaces internos.
Cuando empecé a hacer SEO en 2006, una de las cosas que hacíamos era poner en negrita y subrayar el texto o agrandar ciertos pasajes para que parecieran más importantes. En los últimos 5 años he visto a gente decir que todavía merece la pena hacerlo. Yo era escéptico, pero ahora veo que Google hace un seguimiento del tamaño medio ponderado de la fuente de los términos en los documentos.
Están haciendo lo mismo con el texto ancla de los enlaces.
Enlaces internos: interpretación de droppedLocalAnchorCount
En muchos de los módulos relacionados con el anclaje, la idea de “local” significa el mismo sitio. Este droppedLocalAnchorCount sugiere que algunos enlaces internos no se contabilizan.
No he visto ni una sola mención a Disavow
Aunque los datos de desautorización podrían almacenarse en otro lugar, no se encuentran específicamente en esta API. Lo encuentro específicamente porque los datos de los calificadores de calidad son directamente accesibles aquí. La ausencia de una referencia no demuestra dónde se procesan los datos de desautorización ni si están desvinculados de la clasificación.
Mi suposición a largo plazo ha sido que disavow ha sido un esfuerzo de ingeniería de características de origen popular para entrenar a los clasificadores de spam de Google. Esa conjetura no está demostrada por la ausencia del campo en esta documentación.
Podría seguir hablando de enlaces y de características como IndyRank, PageRankNS, etc., pero basta con decir que Google tiene el análisis de enlaces muy marcado y gran parte de lo que están haciendo no se aproxima a nuestros índices de enlaces. Es un buen momento para reconsiderar sus programas de construcción de enlaces basándose en todo lo que acaba de leer.
Límites de tokens descritos en algunos componentes
Google cuenta el número de tokens y la relación entre el total de palabras del cuerpo y el número de tokens únicos. Los documentos indican que existe un número máximo de tokens que se pueden tener en cuenta para un documento en concreto en el sistema Mustang, lo que refuerza la idea de que los autores deben seguir poniendo su contenido más importante al principio.
OriginalContentScore y la originalidad del contenido breve
Nota editorial: el nombre del atributo no revela una fórmula de originalidad ni una longitud ideal. La guía de contenido útil de Google pide información original, completa y fiable, y descarta un recuento de palabras preferido. Conserva la extensión que necesite la respuesta.
La OriginalContentScore sugiere que los contenidos breves se puntúan por su originalidad. Esta es probablemente la razón por la que el contenido escaso no siempre está en función de la longitud.
A la inversa, también existe una puntuación de relleno de palabras clave.
titlematchScore y la relación entre título y consulta
La documentación indica que existe un titlematchScore. La descripción sugiere que Google sigue valorando la adecuación del título de la página a la consulta.
Conviene que el título identifique con claridad el tema y responda a la intención de búsqueda. Poner una palabra clave siempre en primer lugar no es una regla demostrada por titlematchScore; evita repetir términos y prioriza un título descriptivo.
No hay medidas de recuento de caracteres
A su favor, Gary Ilyes ha dicho que los SEO se inventaron todo el recuento de caracteres óptimos para los metadatos. No hay ninguna métrica en este conjunto de datos que cuente la longitud de los títulos de las páginas o de los fragmentos. La única medida de recuento de caracteres que he encontrado en la documentación es el snippetPrefixCharCount que parece estar configurado para determinar lo que se puede utilizar como parte del snippet.
La ausencia de un contador en este conjunto no demuestra que los títulos largos mejoren la clasificación. Google recomienda títulos descriptivos y concisos, y puede truncarlos según el ancho disponible o generar otro título para el resultado.
Las fechas son muy importantes
Google está muy centrado en los resultados frescos y los documentos ilustran sus numerosos intentos de asociar fechas a las páginas.
- bylineDate: Es la fecha establecida explícitamente en la página.
- syntacticDate : Es una fecha extraída de la URL o en el título.
- semanticDate : Es la fecha derivada del contenido de la página.
Lo mejor es especificar una fecha y ser coherente con ella en los datos estructurados, los títulos de página y los sitemaps XML. Las fechas contradictorias pueden confundir a las personas y a los sistemas que las interpretan. No se deduce de aquí una penalización automática; usa fechas reales y coherentes y no cambies la publicación para aparentar novedad.
La información de registro del dominio se almacena sobre las páginas
Ha sido una teoría conspirativa durante mucho tiempo que el estatus de Google como registrador alimenta el algoritmo. El almacenamiento de información no demuestra esa hipótesis. Almacenan la información de registro más reciente a nivel de documento compuesto.
Como se ha comentado anteriormente, es probable que esto se utilice para informar sobre el aislamiento de nuevos contenidos. También puede utilizarse para bloquear un dominio previamente registrado que ha cambiado de propietario. Sospecho que el peso de esto se ha incrementado recientemente con la introducción de la política de spam de abuso de dominios expirados
Una clasificación de sitios centrados en vídeo
El análisis original menciona un umbral de más del 50% de páginas con vídeo para identificar un sitio centrado en ese formato. Se conserva como interpretación histórica del campo, no como requisito vigente, ventaja SEO ni motivo para añadir vídeos sin utilidad.
Referencias a clasificadores YMYL
La documentación indica que Google dispone de clasificadores que generan puntuaciones para YMYL Health y para YMYL News.
También hacen una predicción de las “consultas marginales” o las que no se han visto antes para determinar si son YMYL o no.
Por último, YMYL se basa en el nivel de trozos, lo que llevó al autor a plantear una relación con incrustaciones. No permite describir todo el sistema ni deducir sus pesos.
Existen documentos de referencia
No hay ninguna indicación de lo que esto significa, pero la descripción menciona “documentos etiquetados por humanos” frente a “anotaciones etiquetadas automáticamente”. Me pregunto si esto es una función de las calificaciones de calidad, pero Google dice que las calificaciones de calidad no afectan a las clasificaciones. Así que puede que nunca lo sepamos.
Site embeddings: afinidad temática, no actualidad de la página
Nota editorial: «topicality» alude a relación temática, no a frescura temporal. Los ejemplos siguientes describen la lectura del autor sobre representaciones vectoriales; no demuestran una regla que obligue a todos los sitios a tratar un solo tema.
Hablaré de las incrustaciones con más detalle en un post posterior, pero vale la pena señalar que Google está vectorizando específicamente páginas y sitios y comparando las incrustaciones de la página con las incrustaciones del sitio para ver lo fuera de tema que está la página.
La puntuación siteFocusScore refleja el grado en que el sitio se ciñe a un único tema. El radio del sitio mide hasta qué punto la página se sale del tema central basándose en los vectores site2vec generados para el sitio.
Una etiqueta de sitio pequeño no demuestra una penalización
Google tiene una bandera específica que indica si un sitio es un “pequeño sitio personal”. No existe una definición de este tipo de sitios, pero basándonos en todo lo que sabemos, no les resultaría difícil añadir un Twiddler que potenciara este tipo de sitios o uno que los degradara.
Los efectos de una actualización sobre sitios pequeños merecen investigación, pero esa etiqueta no demuestra intención de perjudicarlos ni permite explicar una caída concreta. Hay que examinar las páginas, consultas, competencia y cambios técnicos antes de atribuir una causa.
Preguntas abiertas del análisis original
Nota editorial: Baby Panda y la expansión propuesta para NSR son hipótesis históricas. No se presentan como nombres oficiales del sistema de contenido útil ni como definiciones técnicas confirmadas.
Podría seguir, y lo haré, pero es hora de un intermedio. Mientras tanto, sospecho que es inevitable que otros se metan en esta filtración y saquen sus propias conclusiones. De momento, tengo algunas preguntas abiertas que me encantaría que todos nos planteáramos.
¿Es la actualización de contenidos útiles conocida como Baby Panda?
Hay dos referencias a algo llamado “baby panda” en las Señales de Calidad Comprimidas. Baby Panda es un Twiddler que consiste en un ajuste posterior a la clasificación inicial.
Se menciona que funciona sobre Panda, pero no hay más información en la documentación.
Creo que en general estamos de acuerdo en que la Actualización de Contenido Útil tiene muchos de los mismos comportamientos de Panda. La semejanza aparente no prueba que sean el mismo sistema ni permite prescribir una recuperación basada en clics y enlaces.
¿Qué significa NSR? Una pregunta todavía abierta en este análisis
Hay un montón de referencias a módulos y atributos con NSR como parte de la convención de nomenclatura. Muchos de ellos están relacionados con fragmentos de sitios e incrustaciones. Google ya ha hablado anteriormente de “Neural Matching” como uno de los principales objetivos de mejora. Mi conjetura es que NSR significa Neural Semantic Retrieval (recuperación semántica neuronal) y que todas estas funciones están relacionadas con la búsqueda semántica. Sin embargo, en algunos casos mencionan junto a un “site rank”.
El significado de NSR queda abierto en este análisis. No se solicita acceso a intranets, credenciales ni confirmaciones anónimas de información reservada: cualquier aclaración debe proceder de fuentes públicas autorizadas.
Recomendaciones y opiniones del autor original
Como he dicho, no tengo recetas para ti. Sin embargo, tengo algunos consejos estratégicos.
- Envía una disculpa a Rand Fishkin: Desde mi keynote “Todo sobre lo que Google nos mintió” en PubCon, he estado en una campaña para limpiar el nombre de Rand en lo que se refiere a NavBoost. Rand hizo un trabajo ingrato tratando de ayudar a nuestra industria a elevarse durante años. Recibió muchas críticas por parte de Google y del SEO. A veces no hacía las cosas bien, pero su corazón siempre estaba en el lugar correcto y se esforzaba por hacer que lo que hacemos sea respetado y simplemente mejor. King defendió sus experimentos sobre clics, sandbox, subdominios y autoridad de sitio. Esta valoración no convierte todas esas conclusiones en hechos probados: deben evaluarse por separado, con sus métodos y límites. También hay que darle las gracias por este análisis, ya que fue él quien compartió la documentación conmigo. Ahora es un buen momento para que muchos de vosotros le mostréis vuestro cariño en Threads.
- Haz un gran contenido y promociónalo bien: Estoy bromeando, pero también hablo en serio. Google ha seguido dando ese consejo y nosotros lo rechazamos como no procesable. Para algunos SEO está fuera de su control. Después de revisar estas características que dan a Google sus ventajas, es bastante obvio que hacer mejor contenido y promoverlo a audiencias con las que resuene producirá el mejor impacto en esas medidas. Las medidas de las características de los enlaces y el contenido sin duda te llevarán bastante lejos, pero si realmente quieres ganar en Google a largo plazo, vas a tener que hacer cosas que sigan mereciendo clasificar.
- Traer de vuelta los estudios de correlación: Ahora tenemos una comprensión mucho mejor de muchas de las características que Google está utilizando para construir clasificaciones. A través de una combinación de datos de flujo de clics y extracción de características, podemos replicar más de lo que podíamos antes. Creo que ha llegado el momento de recuperar los estudios de correlación verticales específicos.
- Prueba y aprende: Deberías haber visto suficientes gráficos de visibilidad y tráfico con ejes Y para saber que no puedes confiar en nada de lo que leas o escuches en SEO. Esta filtración es otro indicio de que debe tomar las entradas y experimentar con ellas para ver qué funcionará para su sitio web. No basta con mirar las reseñas anecdóticas de las cosas y asumir que así es como funciona Google. Si su organización no tiene un plan de experimentación para SEO, ahora es un buen momento para empezar uno.
Qué puede aprender la comunidad SEO
Una cosa importante que todos podemos sacar de esto es: Los SEO saben lo que hacen. Después de años de que nos digan que estamos equivocados resulta útil disponer de nuevas pistas para revisar nuestras hipótesis, sin concluir que todas fueran correctas. Y, aunque hay matices interesantes de cómo funciona Google en estos documentos, no hay nada que vaya a hacer que cambie drásticamente el rumbo de mi estrategia SEO.
Para aquellos que profundizan, estos documentos servirán principalmente para validar lo que los SEOs experimentados han defendido durante mucho tiempo. Entender a su público, identificar lo que quieren, hacer lo mejor posible que se alinee con eso, hacerlo técnicamente accesible, y promoverlo hasta que se clasifique.
A todos los SEO que no estén seguros de lo que hacen: sigan probando, sigan aprendiendo y sigan haciendo crecer sus negocios. Google no puede hacer lo que hace sin nosotros.
El recurso mencionado en la publicación original
Bueno, alguien va a descargar y organizar todas las características en una hoja de cálculo para ti. También podría ser yo. Sólo nos queda un mes en el trimestre y quiero conseguir nuestros MQL de todos modos.
La publicación original de iPullRank anunciaba una lista organizada de características. Esta página no ofrece una descarga propia ni verifica que aquel recurso siga disponible. La referencia editorial se conserva para entender el cierre del artículo.
Un análisis abierto a nuevas evidencias
Lo que siempre me ha gustado del SEO es que es un rompecabezas en constante evolución. Y aunque ayudar a las marcas a ganar miles de millones de dólares con nuestros esfuerzos es divertido, hay algo muy satisfactorio en alimentar mi curiosidad con todas las pesquisas relacionadas con descifrar cómo funciona Google. Ha sido una gran alegría poder ver por fin detrás del telón.
Esto es todo lo que tengo por ahora, pero ¡hacedme saber lo que encontráis! Cualquiera que quiera compartir algo conmigo puede hacerlo. Soy muy fácil de encontrar.
Palabras de AgenciaCero
Este artículo partió de una traducción de AgenciaCero Group del análisis de Mike King en iPullRank. Esta edición conserva su desarrollo e incorpora precisiones editoriales; no es una traducción literal. La publicación original se puede consultar aquí.
Si encuentras un error háznoslo saber para corregir.
Agradecemos a Mike King que es el fundador y CEO de iPullRank. Profundamente técnico y altamente creativo, La presentación del autor en el texto original le atribuye más de 2.000 millones de dólares en ingresos para sus clientes; no es un resultado de Agencia Cero ni una cifra verificada independientemente en esta revisión. Rapero y hombre de agencia en recuperación. Un tremendo artículo que traemos al español para que los SEO del mundo de LATAM tomen más riesgos para mejorar su batalla contra La Gran G.
Cómo aplicar esta lectura a SEO, AEO y GEO
Para una empresa en Chile o Latinoamérica, el valor práctico está en formular preguntas comprobables, no en perseguir nombres internos. AEO busca responder con claridad a preguntas concretas; GEO aborda la presencia en respuestas generativas. Ninguna de las dos convierte esta documentación histórica en una receta de posicionamiento.
- Define la pregunta y el público de cada página. Revisa si el contenido responde con ejemplos, alcance y límites, sin repetir palabras clave para llenar espacio.
- Comprueba acceso, indexación, enlaces internos, versión canónica y experiencia móvil. Distingue problemas técnicos observables de hipótesis sobre el algoritmo.
- Escribe un título específico y una descripción fiel. Identifica autoría y fuentes; actualiza fechas solo cuando corresponda a cambios reales.
- Registra una línea base por página y consulta. Anota cambios y fechas, compara períodos equivalentes y considera estacionalidad, demanda y competencia. Separa clics, consultas comerciales y ventas verificadas.
- Evalúa una hipótesis por vez cuando sea posible, documenta resultados y evita atribuir causalidad a una simple coincidencia. No compres clics ni enlaces para manipular señales.
Google explica en su documentación de AI Overviews y AI Mode que siguen siendo relevantes las buenas prácticas SEO y que no existe un marcado especial obligatorio para aparecer. La elegibilidad no garantiza indexación, inclusión ni citas. Una respuesta clara, fuentes identificables y contenido visible ayudan a las personas a evaluar la información; no aseguran selección por un sistema generativo.
Preguntas frecuentes sobre la filtración de Google
¿Se filtró el código del algoritmo completo? No es lo que demuestra este material. El artículo comenta documentación de una API y referencias a atributos, no las funciones completas de puntuación ni sus pesos.
¿Los 14.014 atributos son factores de posicionamiento? No puede afirmarse. El recuento citado por King corresponde a atributos documentados, con usos potencialmente distintos y sin confirmación general de vigencia.
¿siteAuthority equivale a Domain Authority? No. Compartir una idea de autoridad no demuestra equivalencia entre un nombre interno y una métrica comercial de terceros.
¿Conviene aumentar clics o alargar los títulos? No como fórmula de ranking. Mejora la pertinencia del contenido y sigue las recomendaciones públicas sobre títulos. Ni la manipulación de clics ni una mayor longitud constituyen una mejora demostrada por esta documentación.
¿Qué cambia para una estrategia en Chile o Latinoamérica? El análisis no establece un algoritmo regional distinto. Conviene trabajar el lenguaje, las preguntas, la oferta y el contexto real del público, con evidencia de las consultas que recibe cada sitio.
De las hipótesis a decisiones que puedas revisar
Si necesitas ordenar qué cambiar y cómo evaluar el resultado, revisa nuestros servicios de diseño web estratégico y analítica digital. El alcance se acuerda según el sitio, las fuentes disponibles y los objetivos del proyecto, sin prometer posiciones ni atribuir resultados que no se hayan medido.



