
O que o vazamento do Google de 2024 revelou?
A documentação do Content Warehouse descrita publicamente em maio de 2024 trouxe nomes de módulos, atributos e estruturas de dados relacionados à busca. Não publicou o algoritmo completo, suas funções de pontuação nem seus pesos. Um campo pode estar armazenado, ser experimental ou obsoleto: sua existência não demonstra seu uso atual no posicionamento.
Esta é uma edição comentada da tradução publicada pela Agencia Cero da análise de Mike King no iPullRank, datada de 27 de maio de 2024. Preservamos seu percurso técnico, exemplos, imagens e referências. A primeira pessoa, a pesquisa, o livro, os clientes e as ofertas comerciais da análise pertencem a King e ao iPullRank, não à Agencia Cero. Os esclarecimentos editoriais distinguem as hipóteses daquela época das evidências públicas e não implicam acesso a sistemas internos.
Como ler: os nomes dos campos são comentados como referências históricas; as interpretações não são instruções garantidas para obter posicionamento. A sentença pública de agosto de 2024, nas seções sobre dados de interação e NavBoost, oferece evidência independente do uso de cliques nesse sistema durante o período examinado. Não prova que cada atributo comentado abaixo esteja ativo hoje nem que aumentar a CTR cause uma melhoria de posição.
Análise histórica: contexto, ressalvas e sistemas
Google, se você está lendo isto, é tarde demais 😉 .
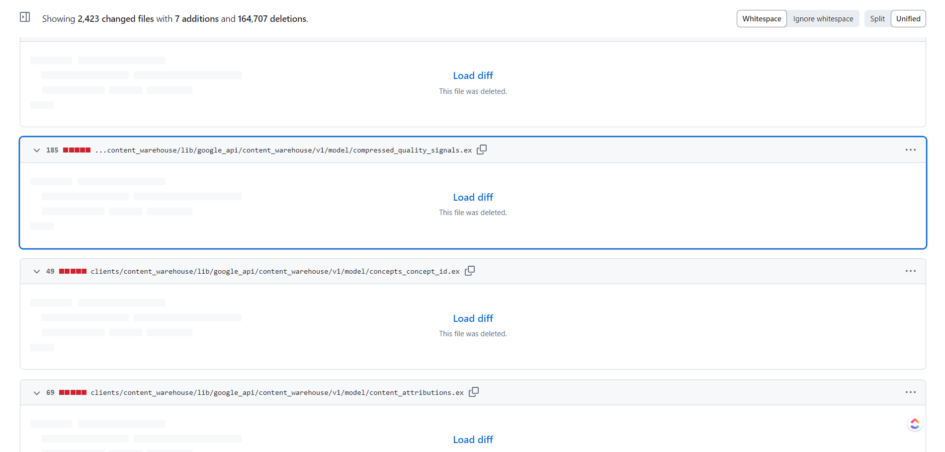
Ok. Estale os dedos. Vamos direto ao ponto. Vazou a documentação interna da API Content Warehouse da Busca do Google. Os microsserviços internos do Google parecem refletir o que o Google Cloud Platform oferece, e a versão interna da documentação do obsoleto Document AI Warehouse foi publicada acidentalmente de forma pública em um repositório de código da biblioteca cliente. A documentação desse código também foi capturada por um serviço externo de documentação automatizada.
Segundo o histórico citado por Mike King em maio de 2024, a publicação acidental foi corrigida em 7 de maio daquele ano. O autor mencionou uma cópia em um serviço de documentação e uma licença Apache 2.0 associada ao repositório. Esta edição não verifica a disponibilidade atual dessas cópias nem interpreta a licença como autorização geral para acessar informações internas, redistribuir qualquer material ou recuperar código privado.
Revisei os documentos de referência da API e os contextualizei com outros vazamentos anteriores do Google e com o depoimento antitruste do Departamento de Justiça. Estou combinando isso com a extensa pesquisa de patentes e white papers realizada para meu próximo livro, The Science of SEO (A ciência do SEO). Embora não haja detalhes sobre as funções de pontuação do Google na documentação que revisei, há uma grande quantidade de informações sobre os dados armazenados para conteúdo, links e interações dos usuários. Também há diferentes níveis de descrição, desde decepcionantemente escassos até surpreendentemente reveladores, das características que são manipuladas e armazenadas.
Seria tentador chamá-los de “fatores de classificação”, mas isso seria impreciso. A presença de um atributo não demonstra que ele seja um fator de classificação, que esteja ativo nem quanto pesa. O que farei aqui é contextualizar alguns dos sistemas e características de classificação mais interessantes, ao menos os que consegui encontrar nas primeiras horas de revisão deste enorme vazamento, com base na minha extensa pesquisa e em coisas que o Google nos contou ou sobre as quais mentiu ao longo dos anos.
No original, King critica duramente as respostas públicas do Google e seu efeito na credibilidade da empresa. Aqui preservamos o debate sobre transparência, mas não apresentamos como fato comprovado uma intenção de enganar. Uma aparente contradição exige comparar data, contexto, definição e alcance de cada declaração.
Ressalvas sobre o artigo
Acho que todos sabemos que as pessoas se esforçarão para desacreditar minhas conclusões e minha análise deste vazamento. Algumas perguntarão por que isso importa e dirão “mas nós já sabíamos disso”. Então, vamos tirar as ressalvas do caminho antes de chegar à parte boa.
- Tempo e contexto limitados: Com o fim de semana de feriado, só consegui dedicar cerca de 12 horas de concentração profunda a tudo isso. Sou incrivelmente grato a algumas pessoas anônimas que ajudaram muito ao compartilhar seus conhecimentos comigo para que eu pudesse me atualizar rapidamente. Além disso, assim como no vazamento do Yandex que cobri no ano passado, não tenho uma visão completa. Enquanto no caso do Yandex tínhamos o código-fonte para analisar e nenhuma das ideias por trás dele, neste caso temos algumas das ideias por trás de milhares de funções e módulos, mas não o código-fonte. Você terá que me perdoar por compartilhar isso de uma forma menos estruturada do que farei em algumas semanas, depois de passar mais tempo com o material.
- Não há funções de pontuação: Não sabemos como as características são ponderadas nas diferentes funções de pontuação posteriores. Não sabemos se tudo o que está disponível é usado. Sabemos que algumas características estão obsoletas. A menos que isso seja indicado explicitamente, não sabemos como as coisas são utilizadas. Não sabemos onde cada coisa acontece no processo. Temos uma série de sistemas de classificação com nomes que correspondem vagamente à forma como o Google os explicou, como os profissionais de SEO observaram os posicionamentos na prática e como os pedidos de patentes e a literatura de recuperação de informação os explicam. Em última análise, graças a esse vazamento, agora temos uma visão mais clara do que está sendo considerado, o que pode orientar aquilo em que nos concentramos ou que ignoramos no SEO daqui para frente.
- Provavelmente o primeiro de vários posts : Este post será minha primeira tentativa de apresentar o que revisei. É possível que eu publique outros textos à medida que continuar aprofundando os detalhes. Suspeito que este artigo levará a comunidade de SEO a correr para analisar esses documentos e, coletivamente, estaremos descobrindo e recontextualizando coisas pelos próximos meses.
- Contexto temporal: King interpretou o material como um retrato de março de 2024 e citou uma publicação em 27 de março e uma retirada em 7 de maio de 2024. Essas datas não demonstram que cada campo estivesse ativo na época nem que descreva o sistema vigente hoje.
- Correlação não é causalidade: Uma associação observada entre uma mudança e o tráfego não prova sua causa. A existência de um campo também não demonstra que ele determine uma posição.
Mais de 14.000 atributos documentados: não equivalem a fatores de posicionamento
Há 2.596 módulos representados na documentação da API, com 14.014 atributos, ou características, que têm esta aparência:
Os módulos estão relacionados a componentes do YouTube, Assistant, Books, busca de vídeos, links, documentos web, infraestrutura de rastreamento, um sistema de calendário interno e a API People. Assim como o Yandex, os sistemas do Google funcionam em um repositório monolítico, ou “monorepo”, e as máquinas operam em um ambiente compartilhado. Isso significa que todo o código é armazenado em um único lugar e que qualquer máquina da rede pode fazer parte de qualquer um dos sistemas do Google.
A documentação vazada descreve cada módulo da API e os divide em resumos, tipos, funções e atributos. A maior parte do que estamos vendo são definições de propriedades para vários buffers de protocolo, ou protobufs, acessados pelos sistemas de classificação para gerar SERPs, Search Engine Result Pages: o que o Google mostra às pessoas depois que fazem uma consulta.
Infelizmente, muitos dos resumos fazem referência a links Go, que são URLs da intranet corporativa do Google e oferecem detalhes adicionais sobre diferentes aspectos do sistema. Sem as credenciais adequadas do Google para acessar e visualizar essas páginas, o que quase certamente exigiria ser um Googler atual da equipe de Busca, ficamos por nossa conta para interpretá-las.
Documentação e declarações públicas: quais diferenças podem ser interpretadas
A análise original questiona se as explicações públicas do Google descreviam adequadamente seus sistemas. É uma crítica do autor, não uma prova de intenção de enganar. Ao comparar declarações e documentação, convém distinguir métricas comerciais de terceiros, nomes internos, sistemas históricos e funcionamento atual.
A seguir, apresento declarações históricas de funcionários do Google junto com interpretações da documentação, com comentários limitados para que você possa julgar por si mesmo.
“Não temos nada parecido com autoridade de domínio”
Os porta-vozes do Google disseram em diversas ocasiões que não utilizam “autoridade de domínio”. King interpretou essas respostas como incompletas; essa avaliação não demonstra, por si só, uma falsidade deliberada.
Ao dizerem que não utilizam autoridade de domínio, poderiam estar dizendo especificamente que não usam a métrica da Moz chamada “Domain Authority” (obviamente). Também poderiam estar dizendo que não medem a autoridade ou a importância de um tema específico, ou domínio, em relação a um site. Essa confusão semântica permite que nunca respondam diretamente à pergunta sobre se calculam ou utilizam métricas de autoridade para o site inteiro.
Gary Ilyes, analista da equipe de Busca do Google que publica informações para ajudar criadores de sites, repetiu essa afirmação em diversas ocasiões.
E Gary não está sozinho. John Mueller, um “defensor da busca que coordena as relações de busca do Google”, declarou neste vídeo: “não temos uma pontuação de autoridade do site”.
Na realidade, como parte dos Sinais de Qualidade Comprimidos armazenados por documento, o Google tem uma característica que calcula chamada “siteAuthority”.
Não sabemos especificamente como siteAuthority é calculado nem como é usado em funções de pontuação. O nome do campo não permite equipará-lo ao Domain Authority da Moz, comprovar seu uso atual em Q* nem deduzir um peso. É uma pista para estudar possíveis sinais do site, não uma métrica que o proprietário possa otimizar diretamente.
“Não usamos cliques para a classificação”
Vamos encerrar isso de uma vez por todas.
O depoimento de Pandu Nayak no julgamento antitruste do DOJ revelou recentemente a existência dos sistemas de classificação Glue e NavBoost. O NavBoost é um sistema que emprega medidas baseadas em cliques para melhorar, rebaixar ou reforçar uma classificação na busca web. Nayak indicou que o Navboost existe desde 2005 e, historicamente, utilizava 18 meses consecutivos de dados de cliques. O sistema foi atualizado recentemente para usar 13 meses de dados e se concentra nos resultados de busca web, enquanto um sistema chamado Glue está associado a outros resultados de busca universal. Mas, mesmo antes dessa revelação, tínhamos várias patentes, incluindo a de 2007 sobre Time Based Ranking, que indicam especificamente como os registros de cliques podem ser usados para alterar os resultados.
Os cliques podem oferecer informações sobre o sucesso de uma busca, mas estão sujeitos a vieses e exigem interpretação. O aprendizado de máquina e as patentes ajudam a formular hipóteses; por si só, não confirmam qual função está em produção. A discussão pública sobre NavBoost deve se apoiar em depoimentos e documentos judiciais, além de comentários de especialistas.
Gary Ilyes abordou essa questão da mensuração de cliques muitas vezes. Em uma ocasião, reforçou o que o engenheiro da Busca do Google Paul Haahr compartilhou em sua palestra na SMX West de 2016 sobre experimentos ao vivo, dizendo que “usar cliques diretamente nos rankings seria um erro”.
Mais tarde, usou sua plataforma para menosprezar Rand Fishkin, fundador e CEO da Moz e veterano em SEO, dizendo que “tempo de permanência, CTR, seja qual for a nova teoria de Fishkin, em geral são lixo inventado”.
Na realidade, o Navboost tem um módulo específico inteiramente dedicado aos sinais de clique.
O resumo desse módulo o define como “sinais de cliques e impressões para Craps”, um dos sistemas de classificação. Como vemos a seguir, são considerados como métricas cliques ruins, cliques bons, últimos cliques mais longos, cliques não comprimidos e últimos cliques mais longos não comprimidos. Segundo a patente do Google “Scoring local search results based on location prominence”, “Squashing é uma função que impede um sinal grande de dominar os demais”. Em outras palavras, os sistemas normalizam os dados de cliques para garantir que não haja manipulação descontrolada baseada no sinal de cliques. Os representantes do Google argumentam que os sistemas presentes em patentes e white papers não são necessariamente os que estão em produção, e essa cautela continua válida: o uso do NavBoost tem evidência pública independente, mas isso não valida cada interpretação dos atributos nem revela seus pesos atuais.
Muitas dessas mesmas medidas baseadas em cliques também aparecem em outro módulo relacionado aos sinais de indexação. Uma das medidas é a data do “último clique bom” em determinado documento. Isso motivou uma hipótese sobre a relação entre interação e perda de tráfego. Não permite diagnosticar uma queda nem demonstrar que exista uma cota esperada de cliques para cada posição.
Além disso, a documentação representa os usuários como eleitores, e seus cliques são armazenados como seus votos. O sistema conta o número de cliques ruins e segmenta os dados por país e dispositivo.
A análise descreve referências ao clique mais longo de uma sessão. Elas não permitem equiparar automaticamente clique longo, tempo de permanência e tempo na página medido pelo Analytics. Também não estabelecem um mínimo de segundos nem justificam prolongar artificialmente a navegação. A prioridade prática é que a pessoa conclua sua tarefa com facilidade.
Várias fontes indicaram que o NavBoost “já é um dos sinais de classificação mais fortes do Google”. A documentação vazada especifica “Navboost” pelo nome 84 vezes, com cinco módulos que incluem Navboost no título. Também há evidências de que consideram sua pontuação nos níveis de subdomínio, domínio raiz e URL, o que indica, intrinsecamente, que tratam de forma diferente os diversos níveis de um site. Não entrarei na discussão de subdomínio versus subdomínio, mas adiante falaremos sobre como os dados do sistema também informaram o algoritmo Panda.
Então, sim, o Google não menciona “CTR” ou “tempo de permanência” com essas palavras exatas nesta documentação, mas o espírito do que Rand demonstrou está incluído: cliques nos resultados de busca e medidas de uma sessão de busca bem-sucedida. As evidências judiciais públicas respaldam o uso histórico de interações no NavBoost. Não demonstram que aumentar a CTR de uma página ou seu tempo no Analytics cause uma melhoria de posição, nem autorizam generalizar cada hipótese do artigo.
“Não há Sandbox”
Os porta-vozes do Google foram categóricos ao afirmar que não existe um sandbox em que sites sejam segregados com base na idade ou na falta de sinais de confiança. Em um tweet agora excluído, John Muller respondeu a uma pergunta sobre quanto tempo leva para se tornar elegível para classificação afirmando: “Não há sandbox”.
No módulo PerDocData, a documentação indica um atributo chamado hostAge usado especificamente “para colocar spam novo em sandbox no momento de servir os resultados”.
A referência a hostAge e a spam novo não demonstra um sandbox universal para todos os sites recentes. O nome e a descrição de um atributo não bastam para deduzir um período fixo de espera nem uma penalização por idade.
“Não usamos nada do Chrome para o ranking”
Anteriormente, Matt Cutts havia sido citado dizendo que o Google não utiliza dados do Chrome como parte da busca orgânica. Mais recentemente, John Mueller reforçou essa ideia.
Um dos módulos relacionados às pontuações de qualidade das páginas apresenta uma medida, no nível do site, das visitas pelo Chrome. Outro módulo que parece estar relacionado à geração de sitelinks também tem um atributo ligado ao Chrome.
Uma apresentação interna vazada de maio de 2016 sobre o sistema RealTime Boost também indica que os dados do Chrome chegariam às buscas. É uma referência histórica que não demonstra, por si só, como esses dados eram usados nem como são usados hoje.
Os porta-vozes do Google têm boas intenções, mas podemos confiar neles?
A resposta exige comparar fontes. Declarações públicas, depoimentos e análises técnicas têm alcances diferentes; um atributo relacionado ao Chrome não demonstra que qualquer visita a partir desse navegador melhore o posicionamento.
Não guardo má vontade contra as pessoas que citei aqui. Tenho certeza de que todas fazem o melhor possível para oferecer apoio e valor à comunidade dentro dos limites permitidos. No entanto, esses documentos deixam claro que devemos continuar tratando o que dizem como uma contribuição, e nossa comunidade deve continuar experimentando para ver o que funciona.
Uma interpretação da arquitetura de busca do Google
Nota editorial: o inventário a seguir é um mapa interpretativo de 2024. Preserva nomes e funções atribuídos por King, não uma especificação técnica atual verificada de ponta a ponta. As analogias com WordPress e os exemplos de restrições de resultados ajudam a explicar possibilidades; não são regras públicas de composição de cada SERP.
Conceitualmente, você pode pensar no “algoritmo do Google” como uma única coisa, uma equação gigante com uma série de fatores de classificação ponderados. Na realidade, trata-se de uma série de microsserviços em que muitas características são pré-processadas e disponibilizadas em tempo de execução para compor a SERP. De acordo com os diferentes sistemas citados na documentação, pode haver mais de cem sistemas de classificação distintos. Supondo que esses não sejam todos os sistemas, talvez cada sistema individual represente um “sinal de classificação”, e talvez seja assim que o Google chega aos 200 sinais de classificação de que costuma falar.
Na palestra de Jeff Dean “Building Software Systems at Google and Lessons Learned”, ele mencionou que as primeiras versões do Google enviavam cada consulta a 1.000 máquinas para processá-la e responder em menos de 250 milissegundos. Também apresentou um diagrama de uma versão anterior da abstração da arquitetura do sistema. Esse diagrama ilustra que Super Root é o cérebro da Busca do Google, que envia as consultas e reúne tudo no final.
O engenheiro de pesquisa de destaque Marc Najork, em sua recente apresentação sobre recuperação generativa de informação, mostrou um modelo abstrato da Busca do Google com seu sistema RAG, também conhecido como Search Generative Experience/AI Overviews. Esse diagrama ilustra uma série de diferentes armazenamentos de dados e servidores que processam as várias camadas de um resultado.
O denunciante do Google Zach Vorhies vazou este slide que mostra as relações entre diferentes sistemas dentro do Google pelos seus nomes internos. Vários deles são citados na documentação.
Usando esses três modelos de alto nível, podemos começar a pensar em como alguns desses componentes trabalham juntos. Pelo que consigo deduzir da documentação, parece que essa API se baseia no Spanner do Google. O Spanner é uma arquitetura distribuída que permite ampliar o armazenamento de dados e a capacidade de processamento, enquanto trata uma série de computadores conectados em rede globalmente como se fossem um só.
É preciso admitir que é um pouco difícil entender a relação entre tudo a partir da documentação, mas o currículo de Paul Haahr oferece uma perspectiva valiosa sobre o que fazem alguns dos sistemas de classificação mencionados. Destacarei os que conheço pelo nome e os segmentarei de acordo com sua função.
Rastreamento
- Trawler: O sistema de rastreamento da web. Possui uma fila de rastreamento, mantém as taxas de rastreamento e compreende a frequência com que as páginas mudam.
Indexação
- Alexandria: O núcleo do sistema de indexação.
- SegIndexer : Sistema que coloca os documentos em níveis dentro do índice.
- TeraGoogle: Sistema de indexação secundário para documentos que permanecem no disco a longo prazo.
Renderização
- HtmlrenderWebkitHeadless: Sistema de renderização para páginas JavaScript. Curiosamente, seu nome vem do Webkit, não do Chromium. O Chromium é mencionado na documentação, por isso é provável que o Google tenha usado WebKit inicialmente e mudado para Headless Chrome assim que ele surgiu.
Processamento
- LinkExtractor: Extrai links das páginas.
- WebMirror: Sistema para gerenciar canonicalização e duplicação.
Classificação
- Mustang: O sistema principal de pontuação, classificação e entrega de resultados.
- Ascorer : O algoritmo principal de classificação, que classifica as páginas antes de qualquer ajuste de reclassificação.
- NavBoost: Sistema de reclassificação baseado nos registros de cliques do comportamento dos usuários.
- FreshnessTwiddler: Sistema de reordenação de documentos baseado na atualidade.
- WebChooserScorer : Define os nomes das características usadas na pontuação de snippets.
Entrega de resultados
- Google Web Server: GWS é o servidor com o qual o frontend do Google interage. Recebe as cargas de dados para exibição ao usuário.
- SuperRoot: É o cérebro da Busca do Google, que envia mensagens aos servidores do Google e gerencia o sistema de pós-processamento para reclassificação e apresentação dos resultados.
- SnippetBrain: O sistema que gera snippets para os resultados.
- Glue: O sistema para reunir resultados universais utilizando o comportamento do usuário.
- Cookbook: Sistema de geração de sinais. Há indícios de que os valores são criados em tempo de execução.
Como já disse, há muitos outros sistemas descritos nesses documentos, mas não está totalmente claro o que fazem. Por exemplo, SAFT e Drishti, do diagrama anterior, também estão representados nesses documentos, mas suas funções não são claras.
O que são Twiddlers, ou ajustes de reclassificação?
Há pouca informação online sobre os Twiddlers em geral, por isso acho que vale a pena explicá-los aqui para contextualizarmos melhor os diferentes sistemas Boost encontrados nos documentos.
Os Twiddlers são funções de reclassificação executadas depois do algoritmo principal de busca, Ascorer. Funcionam de forma semelhante aos filtros e ações do WordPress, em que o que será exibido é ajustado imediatamente antes de ser apresentado ao usuário. Os Twiddlers podem ajustar a pontuação de recuperação de informação de um documento ou alterar sua classificação. Muitos dos experimentos ao vivo e sistemas com nomes que conhecemos são implementados dessa maneira. Como este Xoogler demonstra, eles são bastante importantes em vários sistemas do Google:
Os Twiddlers podem oferecer restrições de categoria, o que significa que a diversidade pode ser promovida limitando especificamente o tipo de resultado. Por exemplo, o autor pode decidir permitir apenas 3 posts de blog em uma determinada SERP. Isso pode esclarecer quando obter posicionamento é uma causa perdida com base no formato da sua página.
Quando o Google diz que algo como Panda não fazia parte do algoritmo principal, provavelmente significa que foi lançado como um Twiddler, como um cálculo de melhoria ou rebaixamento na reclassificação, e depois foi transferido para a função principal de pontuação. Pense nisso como algo semelhante à diferença entre renderização do lado do servidor e do lado do cliente.
Presumivelmente, qualquer característica com o sufixo Boost opera usando a estrutura Twiddler. Estes são alguns dos Boosts identificados na documentação:
- NavBoost
- QualityBoost
- RealTimeBoost
- WebImageBoost
Os nomes orientam hipóteses, mas não explicam, por si só, a função, a implementação ou o uso atual de cada sistema.
Também há um documento interno sobre Twiddlers que revisei e que fala disso com mais detalhes, mas este post soa como se o autor tivesse visto o mesmo documento que eu.
Descobertas e hipóteses para revisar uma estratégia de SEO
Vamos ao que você realmente veio buscar. O que o Google está fazendo que não sabíamos ou sobre o que não tínhamos certeza, e como isso pode afetar meus esforços de SEO?
Uma observação rápida antes de continuar. Meu objetivo é sempre apresentar novos conceitos ao setor de SEO. Meu objetivo não é oferecer uma receita de como utilizá-los no seu caso específico. Se é isso que você quer, deve contratar o iPullRank para seu SEO. Caso contrário, sempre há material mais do que suficiente para você extrapolar e desenvolver seus próprios casos de uso.
Hipóteses sobre Panda a partir de patentes
Nota editorial: uma patente descreve uma invenção, não certifica sua implantação. A fórmula e as citações a seguir são preservadas como exemplos do raciocínio do autor. Segundo o guia público de sistemas do Google, o Panda foi integrado aos sistemas principais em 2015; o sistema de conteúdo útil passou a fazer parte dos sistemas principais em março de 2024.
Quando o Panda foi lançado, houve muita confusão. É aprendizado de máquina? Usa sinais dos usuários? Por que precisamos de uma atualização para nos recuperar? É para o site inteiro? Por que perdi tráfego em um determinado subdiretório?
O Panda foi lançado sob a direção de Amit Singhal. Singhal era decididamente contrário ao aprendizado de máquina devido à sua observabilidade limitada. De fato, há uma série de patentes focadas na qualidade dos sites para o Panda, mas aquela em que quero me concentrar é a pouco descritiva “Classificação dos resultados de busca”. A patente esclarece que o Panda é muito mais simples do que pensávamos. Trata-se, em grande parte, de construir um modificador de pontuação baseado em sinais distribuídos relacionados ao comportamento dos usuários e aos links externos. Esse modificador pode ser aplicado no nível de domínio, subdomínio ou subdiretório.
“O sistema gera um fator de modificação para o grupo de recursos a partir da contagem de links independentes e da contagem de consultas de referência (etapa 306). Por exemplo, o fator de modificação pode ser uma proporção entre o número de links independentes para o grupo e o número de consultas de referência para o grupo. Ou seja, o fator de modificação (M) pode ser expresso como:
M=IL/RQ,
em que IL é o número de links independentes contados para o grupo de recursos, e RQ é o número de consultas de referência contadas para o grupo de recursos.”
Os links independentes são basicamente o que consideramos domínios raiz que apontam links, mas as consultas de referência são um pouco mais complicadas. É assim que são definidas na patente:
“Uma consulta de referência para um grupo específico de recursos pode ser uma consulta de busca enviada anteriormente que foi categorizada como referente a um recurso no grupo específico de recursos. A categorização de uma consulta de busca específica enviada anteriormente como referente a um recurso no grupo específico de recursos pode incluir: determinar que a consulta de busca específica enviada anteriormente contém um ou mais termos que foram determinados como referentes ao recurso no grupo específico de recursos.”
King relacionou as consultas de referência da patente ao NavBoost. É uma interpretação do autor; nem uma patente nem o nome de um campo provam que essa equivalência descreva a implementação do Panda.
Isso sugere que as atualizações do Panda eram simplesmente atualizações da janela móvel de consultas, de forma semelhante a como funcionam os cálculos de Core Web Vitals. Também poderia significar que as atualizações do grafo de links não eram processadas em tempo real para o Panda.
Não é para polemizar, mas outra patente do Panda, a pontuação de qualidade do site, também considera uma pontuação que é uma proporção entre consultas de referência e seleções ou cliques do usuário.
A recomendação prática é atrair um público pertinente, desenvolver conteúdo útil e facilitar uma boa experiência. A fórmula da patente é preservada como exemplo de um mecanismo proposto, não como fórmula operacional do Panda. Não há base aqui para prometer recuperação de uma atualização por meio de mais cliques, mais links ou uma proporção específica entre ambos.
Os autores são uma característica explícita
Muito foi escrito sobre E-E-A-T. Muitos profissionais de SEO são céticos devido ao quanto é nebuloso pontuar experiência e autoridade. Também destaquei anteriormente como há pouca marcação de autor na web. Antes de conhecer os embeddings vetoriais, eu não acreditava que a autoria fosse um sinal suficientemente viável na escala da web.
Ainda assim, o Google armazena explicitamente, como texto, os autores associados a um documento:
Também procura determinar se uma entidade na página é igualmente sua autora.
Isso, combinado com o mapeamento abrangente de entidades e embeddings mostrado nesses documentos, sugere que os sistemas podem representar autores e entidades. Não demonstra uma pontuação universal de autoria nem uma bonificação automática por acrescentar uma assinatura.
Possíveis rebaixamentos algorítmicos
Nota editorial: esses rótulos e suas possíveis funções pertencem à análise original. Em particular, Nav Demotion, os rebaixamentos de localização e a associação com reviews são interpretações, não diagnósticos que possam ser aplicados a um site pelo nome de um campo.
Há uma série de rebaixamentos algorítmicos comentados na documentação. As descrições são limitadas, mas vale a pena mencioná-los. Já falamos do Panda, mas os outros rebaixamentos que encontrei são:
- Anchor Mismatch: Quando o link não corresponde ao site de destino para o qual aponta, ele é rebaixado nos cálculos. Como já disse, o Google procura relevância nos dois lados de um link.
- Rebaixamento da SERP: Sinal que indica um rebaixamento baseado em fatores observados na SERP, sugerindo uma possível insatisfação do usuário com a página, provavelmente medida pelos cliques.
- Nav Demotion: Presumivelmente, trata-se de um rebaixamento aplicado a páginas que apresentam práticas ruins de navegação ou problemas de experiência do usuário.
- Rebaixamento de domínios de correspondência exata: No final de 2012, Matt Cutts anunciou que os domínios de correspondência exata não receberiam tanto valor quanto recebiam historicamente. Existe uma característica específica para seu rebaixamento.
- Product Review Demotion: Não há informação específica sobre isso, mas está listado como um rebaixamento e provavelmente relacionado à recente atualização de avaliações de produtos de 2023.
- Rebaixamento de localização: É indicado que páginas “globais” e “superglobais” podem ser rebaixadas. Isso sugere que o Google tenta associar páginas a uma localização e classificá-las de acordo com ela.
- Rebaixamentos de pornografia: Este é bastante óbvio.
- Outros rebaixamentos de links: Veremos isso na próxima seção.
Todos esses rebaixamentos potenciais podem orientar uma estratégia, mas, se formos honestos, tudo se resume a criar conteúdo excelente com uma experiência de usuário forte e construir uma marca.
Os links continuam importantes
Não vi nenhuma evidência que refute as afirmações recentes de que os links são considerados menos importantes. Mais uma vez, é provável que isso se deva às próprias funções de pontuação, não à forma como as informações são armazenadas. Dito isso, houve muito cuidado na extração e na engenharia de características para compreender profundamente o grafo de links.
Hipóteses sobre o nível de indexação e o valor dos links
Uma métrica chamada sourceType mostra uma relação pouco clara entre o lugar em que uma página é indexada e seu valor. Para você ter uma ideia, o índice do Google é estratificado em níveis, nos quais o conteúdo mais importante, atualizado e acessado regularmente, é armazenado em memória flash. O conteúdo menos importante é armazenado em unidades de estado sólido, e o conteúdo atualizado de forma irregular fica em discos rígidos comuns.
King interpretou esses níveis como uma possível relação entre armazenamento e avaliação de links. O atributo sourceType não basta para provar essa relação nem a regra de que uma página recente oferece um link mais valioso. A atualidade, a relevância e a utilidade de uma referência devem ser avaliadas por seu contexto, não por uma suposta localização física no índice.
Sinais de velocidade de spam de links
Há uma série inteira de métricas sobre a identificação de picos de texto âncora de spam. Considerando a característica phraseAnchorSpamDays, o Google tem efetivamente a capacidade de medir a velocidade de links de spam.
Isso poderia ser facilmente usado para identificar quando um site está fazendo spam e para anular um ataque de SEO negativo. Para quem é cético sobre o último caso, o Google pode usar esses dados para comparar uma linha de base de descoberta de links com uma tendência atual e simplesmente não contabilizar esses links em nenhuma direção.
A referência a 20 versões não demonstra um limite geral do Google
Já falei anteriormente sobre como o sistema de arquivos do Google consegue armazenar versões de páginas ao longo do tempo de forma semelhante à Wayback Machine. A análise propõe que o Google pode preservar versões históricas, mas não demonstra que armazene indefinidamente tudo o que indexou. Essa é uma das razões pelas quais não é possível simplesmente redirecionar uma página para um destino irrelevante e esperar que o valor dos links seja transferido.
Os documentos reforçam essa ideia ao sugerir que armazenam todas as mudanças que viram na página.
Quando trazem dados para comparação ao recuperar DocInfo, consideram apenas as últimas 20 versões da página.
A referência a 20 versões corresponde à interpretação desse componente. Não demonstra que 20 mudanças ou solicitações de indexação apaguem o histórico de uma URL. Corrigir conteúdo e redirecionamentos deve responder à sua pertinência e utilidade, não a uma suposta fórmula de “apagar e começar de novo”.
PageRank da página inicial: possíveis relações entre documentos
Cada documento tem associado o PageRank de sua página inicial, na versão Nearest Seed. É provável que seja usado como aproximação para páginas novas até que obtenham seu próprio PageRank.
É provável que isso e siteAuthority sejam usados como aproximações para páginas novas até que tenham seu próprio PageRank calculado.
Confiança da página inicial
A documentação levou King a propor que a confiança associada à página inicial poderia participar da avaliação de links. Aqui não se demonstra seu uso, peso nem aplicação atual.
Como sempre, você deve se concentrar na qualidade e na relevância dos seus links, não no volume.
Tamanho da fonte: uma característica documentada, não uma tática comprovada
Nota editorial: registrar características de apresentação não prova que aumentar textos ou links melhore posições. Use hierarquia visual por legibilidade e acessibilidade. Da mesma forma, droppedLocalAnchorCount não demonstra, por si só, que o Penguin elimine links internos.
Quando comecei a fazer SEO em 2006, uma das coisas que fazíamos era colocar texto em negrito e sublinhá-lo ou aumentar certos trechos para que parecessem mais importantes. Nos últimos 5 anos, vi pessoas dizerem que ainda vale a pena fazer isso. Eu era cético, mas agora vejo que o Google acompanha o tamanho médio ponderado da fonte dos termos nos documentos.
Eles fazem o mesmo com o texto âncora dos links.
Links internos: interpretação de droppedLocalAnchorCount
Em muitos módulos relacionados a âncoras, a ideia de “local” significa o mesmo site. Esse droppedLocalAnchorCount sugere que alguns links internos não são contabilizados.
Não vi uma única menção a Disavow
Embora os dados de rejeição de links possam ser armazenados em outro lugar, eles não são encontrados especificamente nesta API. Destaco isso porque os dados dos avaliadores de qualidade são diretamente acessíveis aqui. A ausência de uma referência não demonstra onde os dados de rejeição são processados nem se estão desvinculados da classificação.
Minha suposição de longa data é que disavow foi um esforço de engenharia de características por colaboração coletiva para treinar os classificadores de spam do Google. Essa conjectura não é demonstrada pela ausência do campo nesta documentação.
Eu poderia continuar falando sobre links e características como IndyRank, PageRankNS etc., mas basta dizer que o Google tem a análise de links muito desenvolvida, e grande parte do que faz não é aproximada pelos nossos índices de links. É um bom momento para reconsiderar seus programas de construção de links com base em tudo o que acabou de ler.
Limites de tokens descritos em alguns componentes
O Google conta o número de tokens e a proporção entre o total de palavras do corpo e o número de tokens únicos. Os documentos indicam que existe um número máximo de tokens que podem ser considerados para um determinado documento no sistema Mustang, o que reforça a ideia de que os autores devem continuar colocando seu conteúdo mais importante no início.
OriginalContentScore e a originalidade do conteúdo curto
Nota editorial: o nome do atributo não revela uma fórmula de originalidade nem um tamanho ideal. O guia de conteúdo útil do Google pede informações originais, completas e confiáveis e descarta uma contagem de palavras preferida. Preserve a extensão de que a resposta precisa.
OriginalContentScore sugere que conteúdos curtos são pontuados por sua originalidade. Essa é provavelmente a razão pela qual conteúdo superficial nem sempre depende da extensão.
Por outro lado, também existe uma pontuação de excesso de palavras-chave.
titlematchScore e a relação entre título e consulta
A documentação indica que existe um titlematchScore. A descrição sugere que o Google continua valorizando a adequação do título da página à consulta.
Convém que o título identifique claramente o tema e responda à intenção de busca. Colocar uma palavra-chave sempre em primeiro lugar não é uma regra demonstrada por titlematchScore; evite repetir termos e priorize um título descritivo.
Não há medidas de contagem de caracteres
A seu favor, Gary Ilyes disse que os profissionais de SEO inventaram toda a questão da contagem ideal de caracteres para metadados. Não há nenhuma métrica neste conjunto de dados que conte o tamanho dos títulos das páginas ou dos snippets. A única medida de contagem de caracteres que encontrei na documentação é snippetPrefixCharCount, que parece estar configurada para determinar o que pode ser usado como parte do snippet.
A ausência de um contador nesse conjunto não demonstra que títulos longos melhorem a classificação. O Google recomenda títulos descritivos e concisos e pode truncá-los conforme a largura disponível ou gerar outro título para o resultado.
As datas são muito importantes
O Google está muito focado em resultados recentes, e os documentos ilustram suas numerosas tentativas de associar datas às páginas.
- bylineDate: É a data estabelecida explicitamente na página.
- syntacticDate : É uma data extraída da URL ou do título.
- semanticDate : É a data derivada do conteúdo da página.
O melhor é especificar uma data e ser coerente com ela nos dados estruturados, títulos de página e sitemaps XML. Datas contraditórias podem confundir as pessoas e os sistemas que as interpretam. Não se deduz daqui uma penalização automática; use datas reais e coerentes e não altere a publicação para aparentar novidade.
As informações de registro do domínio são armazenadas sobre as páginas
Há muito tempo existe a teoria conspiratória de que a condição do Google como registrador alimenta o algoritmo. O armazenamento de informações não demonstra essa hipótese. Eles armazenam as informações de registro mais recentes no nível do documento composto.
Como comentado anteriormente, é provável que isso seja usado para orientar o isolamento de novos conteúdos. Também pode ser usado para bloquear um domínio previamente registrado que mudou de proprietário. Suspeito que seu peso tenha aumentado recentemente com a introdução da política de spam sobre abuso de domínios expirados
Uma classificação de sites focados em vídeo
A análise original menciona um limite de mais de 50% das páginas com vídeo para identificar um site focado nesse formato. Isso é preservado como interpretação histórica do campo, não como requisito vigente, vantagem de SEO nem motivo para acrescentar vídeos sem utilidade.
Referências a classificadores YMYL
A documentação indica que o Google possui classificadores que geram pontuações para YMYL Health e YMYL News.
Também fazem uma previsão das “consultas marginais”, ou daquelas que não foram vistas antes, para determinar se são YMYL ou não.
Por fim, YMYL se baseia no nível de trechos, o que levou o autor a propor uma relação com embeddings. Isso não permite descrever todo o sistema nem deduzir seus pesos.
Existem documentos de referência
Não há indicação do que isso significa, mas a descrição menciona “documentos rotulados por humanos” em comparação com “anotações rotuladas automaticamente”. Pergunto-me se isso é uma função das avaliações de qualidade, mas o Google diz que as avaliações de qualidade não afetam os posicionamentos. Então, talvez nunca saibamos.
Site embeddings: afinidade temática, não atualidade da página
Nota editorial: “topicality” se refere à relação temática, não à atualidade temporal. Os exemplos a seguir descrevem a leitura do autor sobre representações vetoriais; não demonstram uma regra que obrigue todos os sites a tratar de um único tema.
Falarei sobre embeddings com mais detalhes em um post posterior, mas vale ressaltar que o Google está vetorizando especificamente páginas e sites e comparando os embeddings da página com os do site para ver o quanto a página está fora do tema.
A pontuação siteFocusScore reflete o grau em que o site se mantém em um único tema. O raio do site mede o quanto a página se afasta do tema central com base nos vetores site2vec gerados para o site.
Um rótulo de site pequeno não demonstra uma penalização
O Google tem uma flag específica que indica se um site é um “pequeno site pessoal”. Não existe uma definição desse tipo de site, mas, com base em tudo o que sabemos, não seria difícil acrescentar um Twiddler que favorecesse esses sites ou outro que os rebaixasse.
Os efeitos de uma atualização sobre sites pequenos merecem investigação, mas esse rótulo não demonstra intenção de prejudicá-los nem permite explicar uma queda concreta. É preciso examinar páginas, consultas, concorrência e mudanças técnicas antes de atribuir uma causa.
Perguntas abertas da análise original
Nota editorial: Baby Panda e a expansão proposta para NSR são hipóteses históricas. Não são apresentadas como nomes oficiais do sistema de conteúdo útil nem como definições técnicas confirmadas.
Eu poderia continuar, e vou continuar, mas é hora de um intervalo. Enquanto isso, suspeito que seja inevitável que outras pessoas mergulhem nesse vazamento e tirem suas próprias conclusões. Por enquanto, tenho algumas perguntas abertas que adoraria que todos nós considerássemos.
A atualização de conteúdo útil é conhecida como Baby Panda?
Há duas referências a algo chamado “baby panda” nos Sinais de Qualidade Comprimidos. Baby Panda é um Twiddler que consiste em um ajuste posterior à classificação inicial.
É mencionado que ele funciona sobre o Panda, mas não há mais informações na documentação.
Acredito que, em geral, concordamos que a Atualização de Conteúdo Útil apresenta muitos dos mesmos comportamentos do Panda. A semelhança aparente não prova que sejam o mesmo sistema nem permite prescrever uma recuperação baseada em cliques e links.
O que significa NSR? Uma pergunta ainda aberta nesta análise
Há muitas referências a módulos e atributos com NSR como parte da convenção de nomenclatura. Muitos estão relacionados a trechos de sites e embeddings. O Google já falou anteriormente de “Neural Matching” como um dos principais focos de melhoria. Minha conjectura é que NSR significa Neural Semantic Retrieval, ou recuperação semântica neural, e que todas essas características estão relacionadas à busca semântica. No entanto, em alguns casos, ele é mencionado junto de um “site rank”.
O significado de NSR permanece aberto nesta análise. Não é solicitado acesso a intranets, credenciais nem confirmações anônimas de informações restritas: qualquer esclarecimento deve vir de fontes públicas autorizadas.
Recomendações e opiniões do autor original
Como disse, não tenho receitas para você. No entanto, tenho alguns conselhos estratégicos.
- Envie um pedido de desculpas a Rand Fishkin: Desde minha keynote “Tudo sobre o que o Google mentiu para nós” na PubCon, estou em uma campanha para limpar o nome de Rand no que se refere ao NavBoost. Rand fez um trabalho ingrato tentando ajudar nosso setor a evoluir durante anos. Recebeu muitas críticas do Google e do mundo do SEO. Às vezes não acertava, mas seu coração sempre esteve no lugar certo, e ele se esforçava para tornar o que fazemos respeitado e simplesmente melhor. King defendeu seus experimentos sobre cliques, sandbox, subdomínios e autoridade do site. Essa avaliação não transforma todas essas conclusões em fatos comprovados: elas devem ser avaliadas separadamente, com seus métodos e limites. Também é preciso agradecê-lo por esta análise, já que foi ele quem compartilhou a documentação comigo. Agora é um bom momento para muitos de vocês demonstrarem seu carinho por ele no Threads.
- Crie um ótimo conteúdo e promova-o bem: Estou brincando, mas também falando sério. O Google continua dando esse conselho, e nós o rejeitamos como algo que não permite uma ação concreta. Para alguns profissionais de SEO, está fora de seu controle. Depois de revisar essas características que dão vantagens ao Google, é bastante óbvio que criar conteúdo melhor e promovê-lo para públicos com os quais tenha afinidade produzirá o maior impacto nessas medidas. As medidas das características de links e conteúdo certamente levarão você bastante longe, mas, se realmente quiser vencer no Google a longo prazo, terá que fazer coisas que continuem merecendo se posicionar.
- Traga de volta os estudos de correlação: Agora entendemos muito melhor muitas das características que o Google usa para construir classificações. Por meio de uma combinação de dados de fluxo de cliques e extração de características, podemos replicar mais do que antes. Acredito que chegou a hora de trazer de volta os estudos de correlação específicos por setor.
- Teste e aprenda: Você já deve ter visto gráficos de visibilidade e tráfego com eixos Y suficientes para saber que não pode confiar em tudo o que lê ou ouve em SEO. Este vazamento é mais um indício de que deve pegar as informações e experimentá-las para ver o que funcionará no seu site. Não basta olhar relatos anedóticos e presumir que é assim que o Google funciona. Se sua organização não tem um plano de experimentação para SEO, agora é um bom momento para começar.
O que a comunidade de SEO pode aprender
Uma coisa importante que todos podemos tirar disso é: os profissionais de SEO sabem o que fazem. Depois de anos ouvindo que estamos errados, é útil dispor de novas pistas para revisar nossas hipóteses, sem concluir que todas estavam corretas. E, embora haja nuances interessantes sobre o funcionamento do Google nesses documentos, não há nada que me faça mudar drasticamente o rumo da minha estratégia de SEO.
Para quem se aprofunda, esses documentos servirão principalmente para validar o que profissionais experientes de SEO defendem há muito tempo. Entenda seu público, identifique o que ele quer, faça o melhor possível para atender a isso, torne-o tecnicamente acessível e promova até conseguir posicionamento.
A todos os profissionais de SEO que não têm certeza do que fazem: continuem testando, continuem aprendendo e continuem fazendo seus negócios crescerem. O Google não consegue fazer o que faz sem nós.
O recurso mencionado na publicação original
Bem, alguém vai baixar e organizar todas as características em uma planilha para você. Posso muito bem ser eu. Só resta um mês no trimestre, e quero atingir nossos MQLs de qualquer maneira.
A publicação original do iPullRank anunciava uma lista organizada de características. Esta página não oferece um download próprio nem verifica se aquele recurso continua disponível. A referência editorial é preservada para compreender o encerramento do artigo.
Uma análise aberta a novas evidências
O que sempre gostei no SEO é que ele é um quebra-cabeça em constante evolução. E, embora ajudar marcas a ganhar bilhões de dólares com nossos esforços seja divertido, há algo muito satisfatório em alimentar minha curiosidade com todas as investigações envolvidas em descobrir como o Google funciona. Foi uma grande alegria finalmente poder olhar por trás da cortina.
É tudo o que tenho por enquanto, mas me contem o que encontrarem! Qualquer pessoa que queira compartilhar algo comigo pode fazer isso. Sou muito fácil de encontrar.
Palavras da Agencia Cero
Este artigo partiu de uma tradução da Agencia Cero Group da análise de Mike King no iPullRank. Esta edição preserva seu desenvolvimento e incorpora esclarecimentos editoriais; não é uma tradução literal. A publicação original pode ser consultada aqui.
Se encontrar um erro, avise-nos para que possamos corrigi-lo.
Agradecemos a Mike King, fundador e CEO do iPullRank. Profundamente técnico e altamente criativo, a apresentação do autor no texto original lhe atribui mais de 2.000 milhões de dólares em receitas para seus clientes; não é um resultado da Agencia Cero nem um número verificado de forma independente nesta revisão. Rapper e homem de agência em recuperação. Um artigo extraordinário que trazemos para o espanhol para que os profissionais de SEO do mundo LATAM assumam mais riscos para melhorar sua batalha contra o Grande G.
Como aplicar esta leitura a SEO, AEO e GEO
Para uma empresa no Chile ou na América Latina, o valor prático está em formular perguntas verificáveis, não em perseguir nomes internos. AEO busca responder com clareza a perguntas concretas; GEO aborda a presença em respostas generativas. Nenhum dos dois transforma esta documentação histórica em uma receita de posicionamento.
- Defina a pergunta e o público de cada página. Revise se o conteúdo responde com exemplos, escopo e limites, sem repetir palavras-chave para preencher espaço.
- Confira acesso, indexação, links internos, versão canônica e experiência móvel. Diferencie problemas técnicos observáveis de hipóteses sobre o algoritmo.
- Escreva um título específico e uma descrição fiel. Identifique autoria e fontes; atualize datas apenas quando corresponderem a mudanças reais.
- Registre uma linha de base por página e consulta. Anote mudanças e datas, compare períodos equivalentes e considere sazonalidade, demanda e concorrência. Separe cliques, consultas comerciais e vendas verificadas.
- Avalie uma hipótese por vez quando possível, documente resultados e evite atribuir causalidade a uma simples coincidência. Não compre cliques nem links para manipular sinais.
O Google explica em sua documentação de AI Overviews e AI Mode que as boas práticas de SEO continuam relevantes e que não existe uma marcação especial obrigatória para aparecer. A elegibilidade não garante indexação, inclusão nem citações. Uma resposta clara, fontes identificáveis e conteúdo visível ajudam as pessoas a avaliar as informações; não garantem a seleção por um sistema generativo.
Perguntas frequentes sobre o vazamento do Google
O código do algoritmo completo vazou? Não é isso que este material demonstra. O artigo comenta a documentação de uma API e referências a atributos, não as funções completas de pontuação nem seus pesos.
Os 14.014 atributos são fatores de posicionamento? Não é possível afirmar isso. A contagem citada por King corresponde a atributos documentados, com usos potencialmente diferentes e sem confirmação geral de vigência.
siteAuthority equivale a Domain Authority? Não. Compartilhar uma ideia de autoridade não demonstra equivalência entre um nome interno e uma métrica comercial de terceiros.
Convém aumentar cliques ou alongar os títulos? Não como fórmula de posicionamento. Melhore a pertinência do conteúdo e siga as recomendações públicas sobre títulos. Nem a manipulação de cliques nem uma extensão maior constituem uma melhoria demonstrada por esta documentação.
O que muda para uma estratégia no Chile ou na América Latina? A análise não estabelece um algoritmo regional diferente. Convém trabalhar a linguagem, as perguntas, a oferta e o contexto real do público, com evidências das consultas que cada site recebe.
Das hipóteses às decisões que você pode revisar
Se precisar organizar o que mudar e como avaliar o resultado, veja nossos serviços de web design estratégico e análise de dados digitais. O escopo é acordado conforme o site, as fontes disponíveis e os objetivos do projeto, sem prometer posições nem atribuir resultados que não foram medidos.



